Elke organisatie draait op documenten: contracten, facturen, claims, medische dossiers, vergunningen en aanvragen. Deze documenten worden honderden of duizenden keren per dag uitgewisseld tussen teams, systemen en processen, en in de meeste organisaties gebeurt dat nog steeds grotendeels handmatig.
Documentautomatisering is de praktijk waarbij documentverwerking rechtstreeks wordt geïntegreerd in de workflows, systemen en AI-agenten die organisaties al gebruiken, zodat documenten programmatisch in plaats van handmatig worden verwerkt. Het omvat alles, van het converteren van bestandsformaten en het extraheren van gestructureerde gegevens tot het redigeren van gevoelige informatie en het doorsturen van documenten voor elektronische ondertekening. Het is gebouwd op een speciale, interne documentinfrastructuur en biedt exacte visuele weergave, nauwkeurige gegevensextractie en deterministische uitvoering op schaal met een beschikbaarheid van 99,9+%. De bewerkingen worden eenmalig gedefinieerd en vervolgens automatisch uitgevoerd, geactiveerd door gebeurtenissen in uw bestaande systemen, ongeacht het volume dat het bedrijf nodig heeft.
In deze gids wordt uitgelegd wat documentautomatisering is, hoe het verschilt van standaard documenttools en RPA, welke workflows het afhandelt, hoe organisaties het implementeren (onder meer via AI-agenten) en hoe u kunt beoordelen of dit de juiste stap is voor uw team.
Hoe documentautomatisering verschilt van documenttools
De meeste organisaties beschikken al over documenttools, zoals PDF-bewerkingsprogramma’s, platforms voor elektronische handtekeningen en bestandsopslag. Deze zijn essentieel voor individuele taken, maar vereisen doorgaans dat iemand een applicatie opent, een handeling uitvoert en het resultaat handmatig naar de volgende stap verplaatst.
Documentautomatisering biedt twee belangrijke voordelen voor bedrijfsworkflows. Ten eerste worden de bewerkingen programmatisch uitgevoerd. Ze worden geactiveerd door gebeurtenissen in uw systemen, zoals het uploaden van een bestand, het indienen van een formulier of het bereiken van een specifieke fase in een workflow, en ze worden volledig automatisch uitgevoerd. Ten tweede kunnen workflows worden uitgebreid met optionele AI-mogelijkheden zoals het automatisch extraheren van formuliervelden, het parseren van tabellen, het detecteren van PII en het identificeren van handtekeningvelden, waardoor systemen de inhoud van documenten kunnen interpreteren wanneer slimme verwerking nodig is.
Dit onderscheid is belangrijk, omdat het het verschil is tussen een tool die één persoon helpt om één taak sneller uit te voeren en een systeem dat de taak volledig uit de werklast van die persoon wegneemt.
Inzicht in intelligente documentverwerking (IDP)
Intelligente documentverwerking (IDP) is een term die vaak samen met intelligente documentautomatisering wordt gebruikt. IDP verwijst doorgaans specifiek naar de AI-laag: het vermogen om gegevens uit documenten te extraheren, te classificeren en te interpreteren, inclusief ongestructureerde gegevens waar traditionele, op regels gebaseerde systemen moeite mee hebben.
De termen „AI-documentautomatisering“ en „intelligente documentverwerking“ worden soms door elkaar gebruikt, maar ze beschrijven verschillende toepassingsgebieden. IDP richt zich op de intelligentie: begrijpen wat een document bevat, relevante velden identificeren, documenttypes classificeren en gegevens nauwkeurig extraheren, zelfs wanneer de lay-outs per bron verschillen. Intelligente documentautomatisering is breder. Het omvat IDP-mogelijkheden, maar bestrijkt ook de volledige levenscyclus van documentverwerking, van formaatconversie tot het voltooien van elektronische handtekeningen, geïmplementeerd in de workflows waar het werk daadwerkelijk plaatsvindt.
Een verwante term die af en toe voor verwarring zorgt, is "intelligente gegevensverwerking". Hoewel het vergelijkbaar klinkt, verwijst intelligente gegevensverwerking over het algemeen naar de bredere praktijk van het toepassen van AI op elke gegevenspijplijn – gestructureerd of ongestructureerd – in databases, gegevensstromen en bestanden. IDP richt zich specifiek op documenten: PDF’s, gescande afbeeldingen, formulieren, contracten en andere op bestanden gebaseerde inhoud die informatie bevat waarop organisaties moeten handelen.
Hoe IDP werkt voor formulieren en gegevensextractie
De kernfunctie van intelligente documentverwerking is het omzetten van documentinhoud in gestructureerde, bruikbare gegevens. Voor formulieren betekent dit het identificeren van veldlabels en de bijbehorende waarden, zelfs wanneer de lay-out van formulieren varieert per leverancier, afdeling of regio. Voor tabellen betekent dit het herkennen van rijen, kolommen, kopteksten en celwaarden, en deze vervolgens te extraheren naar een formaat dat direct kan worden geïmporteerd in een CRM-, ERP- of databasesysteem of in een downstream-workflow.
AI-gestuurde extractie gaat verder dan het matchen van patronen. Traditionele benaderingen zijn gebaseerd op sjablonen of vaste coördinaten, die niet meer werken wanneer de lay-out van een document verandert. IDP maakt gebruik van machine learning en natuurlijke taalverwerking om de semantische betekenis van de inhoud op een pagina te begrijpen, zodat het met dezelfde nauwkeurigheid de juiste gegevens kan extraheren uit een factuur die het nog nooit eerder heeft gezien, of een claimformulier van een nieuwe leverancier kan ontleden.
Hoe IDP omgaat met ongestructureerde gegevens
Gestructureerde gegevens, zoals een ingevuld formulier met gelabelde velden, zijn relatief eenvoudig te extraheren. Het moeilijkere probleem zijn ongestructureerde gegevens: alinea’s met vrije tekst in contracten, beschrijvende passages in medische dossiers, handgeschreven notities op gescande documenten of correspondentie met een inconsistente opmaak.
Intelligente documentverwerking pakt dit aan door middel van natuurlijke taalverwerking (NLP) en, in toenemende mate, grote taalmodellen die context kunnen interpreteren, entiteiten kunnen identificeren en betekenis kunnen ontlenen aan tekst die geen vooraf gedefinieerde structuur heeft. Hierdoor kan automatisering sleutelbegrippen uit een contractclausule halen, diagnosecodes in een klinische notitie identificeren of relevante datums in een juridisch dossier markeren, zelfs wanneer geen twee documenten op dezelfde manier zijn opgemaakt.
Welke documentworkflows kan automatisering aan?
Documentautomatisering omvat de operationele stappen die documenten doorlopen tijdens hun levenscyclus binnen een organisatie. Deze stappen zijn vaak onzichtbaar totdat ze vertraging of fouten veroorzaken, maar ze vertegenwoordigen een aanzienlijk deel van de handmatige inspanningen die teams moeten leveren.
Formaatconversie en -optimalisatie
Documenten komen binnen in het ene formaat en moeten in een ander formaat worden omgezet. Word-bestanden moeten worden omgezet naar PDF's voordat ze kunnen worden gearchiveerd. Spreadsheets moeten worden geconverteerd voordat ze kunnen worden bijgevoegd bij een compliance-dossier. Afbeeldingsbestanden moeten worden omgezet naar doorzoekbare PDF's. Deze conversies vinden voortdurend plaats, in elke afdeling, en elk daarvan is een handmatige stap die door automatisering volledig kan worden geëlimineerd.
Een API voor het genereren van PDF-bestanden regelt dit programmatisch: uw systeem verstuurt het bronbestand, specificeert het doelformaat en ontvangt de geconverteerde uitvoer – allemaal zonder handmatige tussenkomst van de gebruiker. De conversie vindt op de achtergrond plaats als onderdeel van een grotere workflow.
Gegevensuitwinning
Een van de meest waardevolle toepassingen van intelligente documentverwerking is het extraheren van gestructureerde gegevens uit documenten die zijn ontworpen om door mensen te worden gelezen. Facturen, contracten, aanmeldingsformulieren, claimdocumenten en financiële overzichten bevatten allemaal gegevens die downstream-systemen nodig hebben, en in de meeste organisaties voert nog steeds iemand die gegevens handmatig in of kopieert deze tussen schermen.
Documentautomatisering haalt formuliervelden, tabelwaarden, regelitems, documenteigenschappen, PII en metadata programmatisch uit documenten met behulp van OCR en stuurt de gestructureerde output rechtstreeks door naar CRM-systemen, ERP-systemen, databases of downstream-workflows. AI-gestuurde extractie gaat variaties in documentindelingen te lijf, zodat het systeem facturen van verschillende leveranciers of intakeformulieren van verschillende vestigingen met dezelfde nauwkeurigheid kan verwerken.
Redactie en naleving
In gereguleerde sectoren moet gevoelige informatie uit documenten worden verwijderd voordat deze kunnen worden gedeeld, gearchiveerd of gepubliceerd. Handmatige redactie is tijdrovend en foutgevoelig, met name bij grote documentensets, waarbij één over het hoofd gezien item al een risico voor de naleving van de regelgeving kan vormen.
Geautomatiseerde redactie maakt gebruik van natuurlijke taalverwerking om PII, financiële gegevens, gezondheidsinformatie en andere gevoelige inhoud in volledige documentensets te identificeren, deze vervolgens definitief te verwijderen en wachtwoordbeveiliging toe te passen om het toegangs- en distributiebeleid af te dwingen. De redactie is consistent, controleerbaar en kan worden uitgevoerd ongeacht het volume dat de workflow vereist.
Documenttransformaties
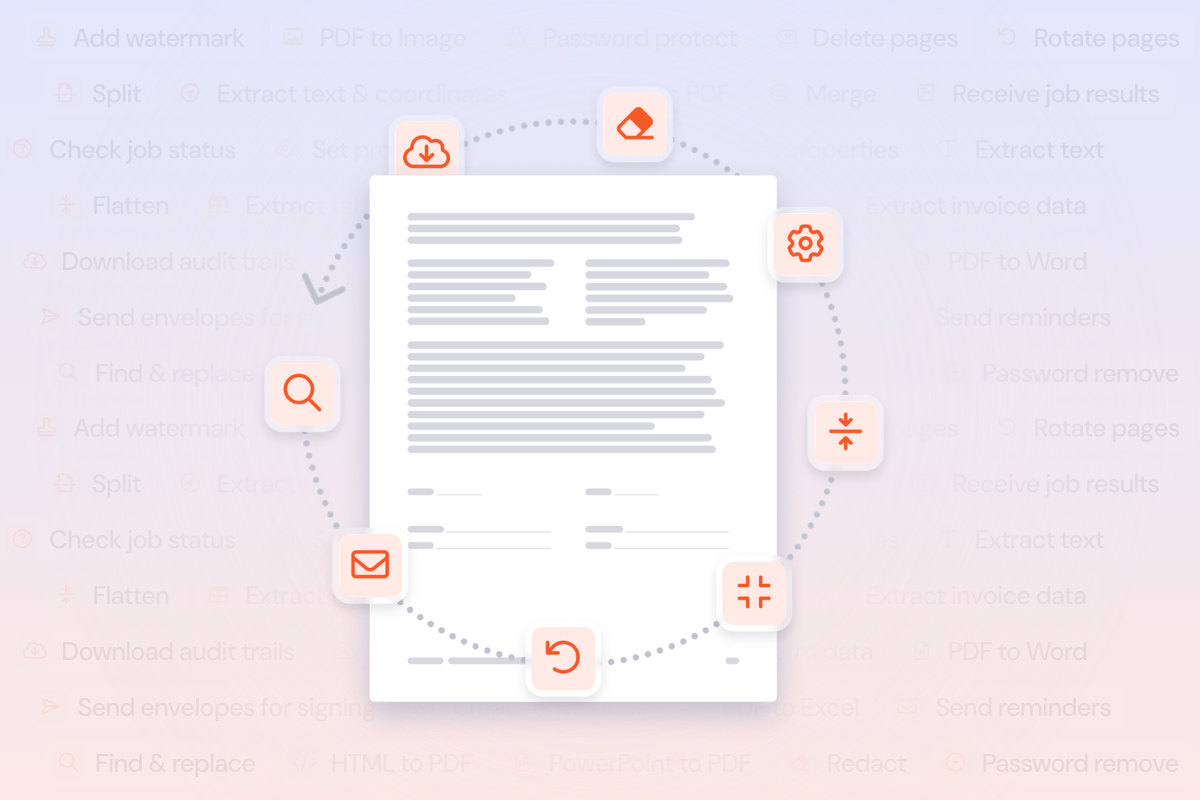
Dit zijn de routinematige bewerkingen die worden uitgevoerd op documenten tijdens de verwerking. Het samenvoegen van meerdere bestanden tot één pakket. Het opsplitsen van een groot document in secties. Het comprimeren van bestanden voor opslag of verzending. Het toepassen van watermerken, wachtwoordbeveiliging of toegangsbeperkingen. Het afvlakken van formulieren vóór archivering. Het draaien van pagina’s, het herschikken van secties of het optimaliseren van de bestandsgrootte.
Afzonderlijk kost elk van deze handelingen een paar minuten. Bij duizenden documenten per maand vormen ze samen een van de grootste bronnen van handmatig werk voor een team. Automatisering van de documentworkflow elimineert deze stappen door de bewerkingen eenmalig te definiëren en ze telkens uit te voeren wanneer een trigger wordt geactiveerd.
Workflows voor elektronische handtekeningen
Elimineer het handmatige werk bij het verzamelen van handtekeningen op uw documenten. Geautomatiseerde workflows voor elektronische handtekeningen verzorgen de volledige cyclus: het automatisch versturen van ondertekeningsverzoeken voor meerdere documenten en meerdere partijen, het bijhouden van de ondertekeningsstatus en het in gang zetten van de volgende stap zodra het ondertekenen is voltooid. De workflow wordt vanaf het moment dat deze wordt geactiveerd volledig zelfstandig uitgevoerd, zonder dat er handmatige tussenkomst nodig is, of dat nu gebeurt door het afsluiten van een deal in uw CRM, het goedkeuren van een claim of het bereiken van de ondertekeningsfase in een onboardingproces.
Waar documentautomatisering de meeste waarde oplevert
Documentautomatisering is toepasbaar in alle sectoren, maar het effect is het meest direct merkbaar in bedrijfsprocessen waar het documentvolume groot is, de verwerking tijdgevoelig is en nauwkeurigheid van groot belang is vanuit regelgevend oogpunt.
- Teams in de financiële dienstverlening verwerken duizenden facturen, afschriften, belastingdocumenten en rapportages voor naleving. Automatisering zorgt voor het op grote schaal extraheren van factuurgegevens, het converteren van PDF-bestanden naar Excel voor financiële overzichten, het samenstellen van belastingdocumentenpakketten en het voorbereiden van rapportages voor regelgevende instanties.
- De crediteurenadministratie is in alle sectoren een van de meest voorkomende startpunten voor intelligente documentverwerking. Crediteurenadministratieteams ontvangen facturen in uiteenlopende formaten van honderden leveranciers, en elke factuur moet worden gekoppeld aan een inkooporder, gevalideerd en doorgestuurd voor goedkeuring. IDP haalt automatisch factuurregels, totalen, leveranciersgegevens en betalingsvoorwaarden uit de facturen en voert deze in het ERP-systeem in, waardoor de handmatige gegevensinvoer – die doorgaans de meeste tijd kost in de crediteurencyclus – komt te vervallen.
- Juridische teams kampen met knelpunten bij het verzamelen van bewijsmateriaal, het beoordelen van contracten en het voorbereiden van gerechtelijke stukken. Automatisering haalt contractvoorwaarden en clausulegegevens eruit, verwerkt bewijsstukken met OCR en redactie, en stelt indieningspakketten samen met de juiste structuur, paginering en beveiligingsmaatregelen.
- Verzekeringsteams beheren de verwerking van grote aantallen schadeclaims, de ontvangst van gescande documenten en het genereren van polisdocumenten. Intelligente documentverwerking in de verzekeringssector automatiseert de ontvangst van schadeclaimdocumenten (vaak gescand of gefotografeerd), haalt de gegevens eruit die schade-experts nodig hebben, classificeert documenttypes en activeert handtekeningverzoeken zodra de dossiers klaar zijn. Dezelfde automatisering is van toepassing op polisverlengingen, aanvragen voor risicobeoordeling en compliance-aangiften.
- Teams in de gezondheidszorg verwerken patiëntenregistratieformulieren, documentatie voor klinische proeven, medische dossiers en facturatiedocumentatie. Intelligente documentverwerking in de gezondheidszorg haalt gestructureerde gegevens uit intakeformulieren, verwerkt medische dossiers met OCR, beheert workflows voor klinische documentatie en ondersteunt automatisering van facturering en codering op de schaal die gezondheidszorgsystemen vereisen. Naleving van de HIPAA en andere regelgeving inzake patiëntgegevens maakt de beveiligingsinfrastructuur achter de automatisering bijzonder belangrijk.
- Logistieke en supply chain-teams verwerken vrachtbrieven, douanedocumentatie, inkooporders en leverancierscontracten bij grote volumes en strakke deadlines. Intelligente documentverwerking voor vervoerders automatiseert het extraheren van verzendgegevens, douaneaangiften en details van handelsfacturen, waardoor de handmatige verwerking die vertragingen veroorzaakt in de haven of tijdens het transport, wordt verminderd.
- Professionele dienstverleners hebben te maken met opdrachtbevestigingen, klantrapporten, auditdocumentatie en kennisbeheer. Automatisering zorgt voor de verwerking van contracten en opdrachtbevestigingen, het genereren van klantrapporten (samenvoegen, converteren, watermerk toevoegen) en het samenstellen van auditdocumentatie.
In beide gevallen ligt de meerwaarde in het wegvallen van handmatige stappen tussen systemen, het verminderen van het foutenpercentage bij repetitieve taken en het vrijmaken van het team om zich te concentreren op het werk dat een eigen oordeel vereist.
4 manieren waarop organisaties documentautomatisering inzetten
Er zijn verschillende manieren om intelligente documentautomatisering in te zetten, en welke de juiste is, hangt af van de technische capaciteiten van het team, de reeds aanwezige systemen en de complexiteit van de betrokken workflows.
1. Directe API-integratieOntwikkelingsteams integreren documentbewerkingen rechtstreeks in maatwerktoepassingen, interne tools en bedrijfssystemen met behulp van PDF- en document-API's. Dit is de juiste aanpak voor interne diensten met grote volumes, ERP-uitbreidingen en maatwerktoepassingen waarbij documentbewerkingen deel uitmaken van het product of de workflow zelf.
Met een API voor het genereren van PDF-bestanden kan een systeem bijvoorbeeld een bronbestand verzenden en een geconverteerde, samengevoegde of verwerkte uitvoer ontvangen als onderdeel van een grotere geautomatiseerde workflow. Authenticatie, tariefbeperking en foutafhandeling volgen standaardpatronen, en de meeste aanbieders bieden documentatie met werkende codevoorbeelden in gangbare programmeertalen.
API-integratie biedt de meeste controle en flexibiliteit. Het is het meest geschikt voor organisaties die grote hoeveelheden documenten moeten verwerken, complexe voorwaardelijke logica moeten hanteren of documentbewerkingen diep in de bestaande architectuur moeten integreren.
2. Low-code- en no-code-platforms
Operationele teams, bedrijfsanalisten en automatiseringsverantwoordelijken kunnen documentbewerkingen toevoegen aan bestaande workflows via platforms zoals Microsoft Power Automate en Zapier. Met kant-en-klare connectoren kunnen teams documentstappen (een bestand converteren, gegevens extraheren, ter ondertekening verzenden) configureren als onderdeel van een grotere geautomatiseerde stroom, allemaal via een visuele interface.
Dit is vaak de snelste manier voor een organisatie om te beginnen met het automatiseren van documentwerk. Het vereist minimale technische middelen en de workflows kunnen worden opgezet en aangepast door de mensen die het dichtst bij het proces staan.
3. AI-agenten en agentgebaseerde documentverwerking
AI-agenten nemen steeds vaker operationele taken voor hun rekening die voorheen menselijke coördinatie vereisten. Dankzij de automatisering van documentworkflows via het Model Context Protocol (MCP) hebben agenten toegang tot dezelfde documentbewerkingen waarop menselijke gebruikers vertrouwen: bestanden converteren, gegevens extraheren, documenten doorsturen voor ondertekening en meer.
Agentgebaseerde documentverwerking gaat nog een stap verder. In plaats van één enkele documentbewerking uit te voeren wanneer daarom wordt gevraagd, kan een AI-agent met toegang tot documentautomatiseringsmogelijkheden zelfstandig meerstapsworkflows coördineren. Een agent kan bijvoorbeeld een e-mailbijlage ontvangen, het documenttype classificeren, de relevante gegevens extraheren, het document naar het juiste systeem doorsturen en een verzoek om ondertekening in gang zetten – en dat alles als onderdeel van één enkele taak. De agent redeneert over wat er moet gebeuren en roept de juiste documentbewerkingen achtereenvolgens op.
Dit is waar documentbeheer en workflowautomatisering samenkomen met AI. De documentbewerkingen zelf zijn hetzelfde (converteren, extraheren, samenvoegen, ondertekenen), maar de coördinerende laag verschuift van een mens die een proces volgt naar een agent die het uitvoert. MCP is het protocol dat dit mogelijk maakt en dat agenten betrouwbare, geauthenticeerde toegang biedt tot document-API’s via dezelfde interface die ze gebruiken voor andere operationele tools.
4. No-code workflowbouwers
Sommige oplossingen voor documentautomatisering bieden visuele workflowbouwers waarmee teams meerstaps documentprocessen kunnen configureren via een canvas met slepen en neerzetten. Deze tools zijn ontworpen voor individuele gebruikers en kleine teams die documentprocessen hebben die het automatiseren waard zijn, maar niet over de middelen beschikken om automatiseringen te bouwen via code of low-code-platforms. Functies zoals kant-en-klare sjablonen, het bewaken van mappen, controlepunten voor beoordeling en AI-ondersteunde workflowgeneratie maken het mogelijk om binnen enkele minuten van idee naar een werkende automatisering te gaan.
Hoe intelligente documentautomatisering zich verhoudt tot RPA
Robotic Process Automation (RPA) en intelligente documentautomatisering worden vaak in één adem genoemd en kunnen goed samenwerken, maar ze lossen verschillende problemen op.
RPA automatiseert repetitieve, op regels gebaseerde taken door menselijke interacties met software-interfaces na te bootsen: op knoppen klikken, gegevens tussen velden kopiëren, door schermen navigeren. Dit is effectief voor processen die een voorspelbare volgorde volgen en interactie hebben met systemen die geen API's hebben. RPA op zichzelf heeft echter beperkte mogelijkheden om de inhoud van documenten te interpreteren. Het kan een bestand van de ene locatie naar de andere verplaatsen, maar is doorgaans afhankelijk van een aparte tool om gegevens uit dat bestand te extraheren of te begrijpen wat erin staat.
Intelligente documentautomatisering biedt de documentspecifieke mogelijkheden die RPA mist: AI-gestuurde extractie, formaatconversie, redigeren en het volledige scala aan PDF- en e-handtekeningbewerkingen. Organisaties die al gebruikmaken van RPA-tools voegen vaak intelligente documentautomatisering toe als de laag die de documentverwerking binnen hun bestaande geautomatiseerde workflows afhandelt.
De twee benaderingen vullen elkaar aan. RPA zorgt voor de navigatie door het systeem en de volgorde van taken; intelligente documentautomatisering zorgt voor de inhoud van het document zelf. Voor organisaties die hun opties evalueren, is de belangrijkste vraag of de bottleneck zit in de systeeminteracties (waar RPA helpt) of in de documentverwerking (waar IDP en documentautomatisering helpen), of in beide.
De markt voor intelligente documentverwerking
De markt voor intelligente documentverwerking is aanzienlijk gegroeid nu organisaties in gereguleerde sectoren hun documentintensieve workflows willen automatiseren. Het landschap omvat verschillende categorieën aanbieders.
Specialisten in documentautomatisering bieden speciaal ontwikkelde API’s en connectoren voor PDF-verwerking, elektronische handtekeningen, gegevensextractie en redigeren. Deze aanbieders richten zich op de documentverwerkingslaag en zijn ontworpen om te worden geïntegreerd in bestaande systemen.
RPA-leveranciers met IDP-uitbreidingen hebben hun platforms uitgebreid met mogelijkheden voor documentverwerking, doorgaans via partnerschappen of overnames. De IDP-mogelijkheden zijn beschikbaar als modules binnen het bredere RPA-platform.
IDP-diensten op cloudplatforms worden aangeboden door grote cloudproviders als onderdeel van hun AI- en machine learning-portfolio's. Deze diensten richten zich voornamelijk op extractie en classificatie, en vereisen doorgaans aanvullend ontwikkelingswerk om volledige documentworkflows op te zetten.
Zelfstandige IDP-platforms richten zich specifiek op documentclassificatie en gegevensextractie, vaak met branchespecifieke modellen. Ze zijn doorgaans sterk op het gebied van intelligentie, maar vereisen mogelijk integratie met afzonderlijke tools voor de operationele kant (conversie, samenvoegen, redigeren, elektronische handtekeningen).
Bij het evalueren van leveranciers is het belangrijk om na te gaan of de oplossing de volledige levenscyclus van de door u benodigde documentverwerking dekt, of alleen het extractiegedeelte. Veel organisaties beginnen met gegevensextractie en komen er al snel achter dat ze ook mogelijkheden nodig hebben voor formaatconversie, redigeren, het samenstellen van documenten en elektronische handtekeningen. Het samenvoegen van meerdere leveranciers zorgt voor extra complexiteit en kosten.
Hoe een oplossing voor documentautomatisering te beoordelen
De keuze voor de juiste oplossing hangt af van de specifieke vereisten van uw organisatie, maar er zijn verschillende aspecten die het waard zijn om zorgvuldig te worden geëvalueerd.
- Breedte van de functionaliteit: Biedt de oplossing het volledige scala aan documentbewerkingen dat uw workflows vereisen? Formaatconversies, gegevensextractie, redigeren, transformaties en workflows voor elektronische handtekeningen moeten allemaal via één enkele aanbieder beschikbaar zijn, zodat u tools kunt consolideren in plaats van meerdere afzonderlijke oplossingen aan elkaar te koppelen.
- Flexibiliteit bij implementatie: Kunt u de oplossing implementeren op de manier die het beste bij uw team past? API-integratie, low-code-connectoren, toegang via AI-agenten en visuele workflowbouwers zijn geschikt voor verschillende teams en verschillende gebruiksscenario’s. De beste oplossingen ondersteunen ze allemaal, zodat een workflow die vandaag in Power Automate is gebouwd, later kan worden omgezet naar een directe API-integratie naarmate uw behoeften veranderen.
- Intelligente verwerking: Beschikt de oplossing over AI-aangedreven mogelijkheden zoals automatische extractie van formuliervelden, het parseren van tabellen, detectie van PII en identificatie van handtekeningvelden? Deze mogelijkheden onderscheiden intelligente documentautomatisering van eenvoudige API’s voor bestandsverwerking.
- Beveiliging en compliance: Voor gereguleerde sectoren is de infrastructuur achter de oplossing net zo belangrijk als de functies. Let op naleving van SOC 2 Type II, ISO 27001 en HIPAA. Controleer of klantgegevens uitsluitend worden verwerkt voor de gevraagde bewerking en of de gegevens worden gebruikt om AI-modellen te trainen. Verifieer of toegangsbeheer, gebruiksmonitoring en controles op API-inloggegevens beschikbaar zijn via een gecentraliseerd beheerportaal.
- Ontwikkelaarservaring: Als uw team via API’s gaat integreren, evalueer dan de ontwikkelaarservaring: de kwaliteit van de openbare documentatie, de consistentie van de authenticatie, de normen voor foutafhandeling, codevoorbeelden en de reactiesnelheid van de technische ondersteuning. Documentbewerkingen op bedrijfsniveau verdienen ontwikkelaarsondersteuning op bedrijfsniveau.
- Commercieel model: Licenties per werkplek zijn voor documentautomatisering vaak minder zinvol dan prijsstelling op basis van gebruik. Zoek naar een model waarbij u betaalt voor de daadwerkelijk uitgevoerde documentbewerkingen, met transparante prijzen en voorspelbare kosten op schaal.
- Analyses en tracking: Zoek naar oplossingen die gebruiksdashboards, kwaliteitsmonitoring en workflowanalyses bieden, zodat u de prestaties van de automatisering kunt volgen, problemen vroegtijdig kunt identificeren en de argumenten kunt opbouwen voor uitbreiding naar aanvullende workflows.
Hoe u aan de slag kunt gaan met het implementeren van documentautomatisering in uw organisatie
Het meest effectieve startpunt is de meest repetitieve documenttaak met het grootste volume die uw team momenteel handmatig afhandelt. Formaatconversies, routinematige gegevensextractie en het beheer van handtekeningverzoeken zijn veelvoorkomende startpunten, omdat deze taken duidelijk gedefinieerd zijn, de handmatige inspanning eenvoudig te kwantificeren is en het voordeel van automatisering onmiddellijk merkbaar is.
Vanaf dat punt breiden de meeste organisaties uit naar complexere workflows, naarmate het team meer vertrouwd raakt met de tools en ontdekt waar de volgende knelpunten zich bevinden.
Een praktische aanpak in 5 stappen:
- Bepaal de workflow: Kies één documentproces dat vaak voorkomt, meerdere handmatige stappen omvat en vertragingen of fouten veroorzaakt. Factuurverwerking, het archiveren van contracten, het verwerken van claims en het opstellen van documenten voor nieuwe medewerkers zijn veelvoorkomende keuzes.
- Breng de stappen in kaart: Leg vast wat er in elke fase met het bestand gebeurt: wat zet het proces in gang, welke bewerkingen of extracties vinden plaats, waar gaat de output naartoe en wie voert momenteel elke stap uit?
- Kies een implementatietraject: Als uw team ontwikkelaars heeft, biedt API-integratie u de meeste controle. Als uw team met Power Automate of Zapier werkt, begin dan met een low-code-connector. Als u snel wilt testen met minimale configuratie, zoek dan naar een begeleide workflowbouwer.
- Meet het resultaat: Houd bij hoeveel tijd er wordt bespaard, hoe handmatige fouten zijn afgenomen en hoe het verwerkingsvolume is toegenomen. Deze cijfers vormen de basis om automatisering uit te breiden naar de volgende workflow.
- Uitbreiden: Zodra de eerste workflow betrouwbaar draait, pas je dezelfde aanpak toe op het volgende proces met de grootste impact. Het implementatietraject, de integratiepatronen en de operationele kennis kun je daarbij gewoon hergebruiken.
Hoe Nitro Automate intelligente documentautomatisering ondersteunt
Nitro Automate transformeert handmatige documentprocessen in geautomatiseerde workflows, waar het werk ook plaatsvindt. Het integreert de documentverwerkingsmogelijkheden van Nitro op enterprise-niveau rechtstreeks in de AI-agenten, geautomatiseerde workflows en aangepaste applicaties die organisaties al gebruiken.
Nitro Automate ondersteunt vier implementatiemogelijkheden:
- API's voor ontwikkelaars: integratie van aangepaste code via talen die HTTP ondersteunen.
- Automatiseringsplatforms: kant-en-klare connectoren voor Microsoft Power Automate en Zapier.
- Nitro MCP-connector: native connectiviteit voor AI-agenten om documenttaken midden in de workflow uit te voeren.
- Nitro PDF Pro (binnenkort beschikbaar): een canvas met slepen-en-neerzetten-functionaliteit direct in Nitro PDF Pro voor geautomatiseerde workflows zonder codering.
Nitro Automate draait op de gecertificeerde infrastructuur van Nitro, die voldoet aan SOC 2 Type II, ISO 27001 en HIPAA. Klantgegevens worden veilig verwerkt en worden nooit gebruikt om generatieve AI-modellen te trainen.
Nitro Automate is nu beschikbaar. Ga voor meer informatie of om een demo aan te vragen naar gonitro.com/automate .
Veelgestelde vragen over Nitro Automate
Wat is intelligente documentverwerking (IDP)? Intelligente documentverwerking (IDP) is het gebruik van AI , waaronder machine learning, natuurlijke taalverwerking en grote taalmodellen, om gegevens uit documenten zoals facturen, contracten, formulieren en gescande documenten te extraheren, te classificeren en te interpreteren. Het zet die inhoud om in gestructureerde gegevens die CRM-systemen, ERP-systemen en andere bedrijfssystemen kunnen gebruiken. Bij traditionele OCR of op sjablonen gebaseerde extractie wordt tekst op vaste posities gelezen. IDP begrijpt daarentegen wat de inhoud betekent, waardoor het zonder vooraf gedefinieerde sjablonen kan omgaan met variërende lay-outs en ongestructureerde tekst. IDP is de AI-laag binnen intelligente documentautomatisering, die ook bewerkingen omvat zoals formaatconversie, redigeren en elektronische ondertekening. IDP is de AI-laag binnen intelligente documentautomatisering, die ook bewerkingen omvat zoals formaatconversie, redigeren en elektronische ondertekening .
Wat is het verschil tussen AI-documentautomatisering en intelligente documentverwerking? Het verschil zit in de reikwijdte. IDP verwijst specifiek naar de door AI aangestuurde extractie en classificatie van documentgegevens. AI-documentautomatisering omvat de volledige levenscyclus van documentbewerkingen: formaatconversie, gegevensextractie, redigeren, documentassemblage, workflows voor elektronische handtekeningen en meer, allemaal geïmplementeerd in geautomatiseerde workflows. IDP is een onderdeel van AI-documentautomatisering, maar documentautomatisering omvat ook de operationele en infrastructuurlagen die documenten van begin tot eind door een workflow leiden.
Wat is agentgebaseerde documentverwerking? Agentgebaseerde documentverwerking is het gebruik van AI-agenten om documentworkflows autonoom te coördineren. In plaats van dat een mens elke stap in gang zet, redeneert een agent over wat er met een document moet gebeuren, roept de juiste bewerkingen op (extraheren, converteren, samenvoegen, doorsturen voor ondertekening) en voltooit de workflow zelfstandig. Agentische documentverwerking wordt mogelijk gemaakt door protocollen zoals het Model Context Protocol (MCP), die AI-agenten geauthenticeerde toegang geven tot document-API’s.
Hoe gaat intelligente documentverwerking om met ongestructureerde gegevens? IDP verwerkt ongestructureerde gegevens door gebruik te maken van natuurlijke taalverwerking (NLP) en machine learning om vrije tekst, verhalende alinea’s, handgeschreven notities en documenten met inconsistente opmaak te interpreteren. In tegenstelling tot op regels gebaseerde systemen die vertrouwen op sjablonen en vaste veldposities, kan IDP betekenis ontlenen aan inhoud zonder vooraf gedefinieerde structuur, zoals contractbepalingen, klinische aantekeningen of correspondentie.
Hoe werkt IDP voor formulieren en gegevensextractie? IDP haalt gegevens uit formulieren door veldlabels en de bijbehorende waarden te identificeren, zelfs wanneer de lay-outs per leverancier of regio verschillen. Bij tabellen herkent IDP rijen, kolommen, kopteksten en celwaarden. De door AI aangestuurde extractie maakt gebruik van machine learning om de semantische relatie tussen labels en gegevens te begrijpen, zodat IDP een formulier dat het nog nooit eerder heeft gezien met dezelfde nauwkeurigheid kan verwerken als een bekend formulier.
Wat is het verschil tussen IDP en RPA? Robotic Process Automation (RPA) automatiseert repetitieve interacties met software-interfaces, zoals klikken, kopiëren en navigeren door schermen. IDP daarentegen verwerkt de inhoud van documenten: gegevens extraheren, typen classificeren, ongestructureerde tekst interpreteren. RPA en IDP vullen elkaar aan. RPA regelt de volgorde van taken op systeemniveau, terwijl IDP de documentinhoud verwerkt. Veel organisaties gebruiken beide samen, waarbij RPA de workflow coördineert en IDP de documentintelligentie levert.
Welke sectoren profiteren het meest van intelligente documentverwerking? IDP levert de meest directe meerwaarde in sectoren met grote documentvolumes, tijdgevoelige verwerking en wettelijke vereisten. De meest voorkomende zijn financiële dienstverlening, verzekeringen, de juridische sector, de gezondheidszorg, logistiek en crediteurenadministratie in alle sectoren. Typische toepassingen zijn onder meer factuurverwerking en nalevingsrapportages in de financiële dienstverlening, het in ontvangst nemen van schadeclaims en polisdocumenten in de verzekeringssector, bewijsgaring en contractbeoordeling in de juridische sector, patiëntendossiers en klinische documentatie in de gezondheidszorg, en douanedocumenten en vrachtbrieven in de logistiek.
Hoe verwerken ondernemingen documenten op grote schaal met IDP? Ondernemingen verwerken documenten op grote schaal met IDP door het in te zetten via API’s die duizenden documenten per uur kunnen verwerken, met AI-gestuurde extractie die de nauwkeurigheid waarborgt bij uiteenlopende lay-outs en documenttypes. De sleutel tot schaalbaarheid is programmatische verwerking: documenten worden automatisch ingelezen, geclassificeerd, verwerkt en doorgestuurd, waarbij menselijke controle is voorbehouden aan uitzonderingen in plaats van aan elk document. Op gebruik gebaseerde prijsmodellen zorgen ervoor dat de kosten voorspelbaar meegroeien met het volume.
Waar moet ik op letten bij het kiezen van een leverancier van intelligente documentverwerking? De belangrijkste overweging bij het evalueren van een IDP-leverancier is of de oplossing de volledige levenscyclus van documenten bestrijkt of alleen de extractielaag. Leveranciers die vereisen dat u meerdere tools aan elkaar koppelt voor een complete workflow, zorgen voor extra complexiteit en kosten. Andere belangrijke evaluatiecriteria zijn onder meer:
- Breedte van de ondersteunde documentbewerkingen (extractie, conversie, roden, elektronische handtekening)
- Flexibiliteit bij de implementatie (API, low-code, toegang voor AI-agenten)
- AI-mogelijkheden voor ongestructureerde gegevens, beveiligingscertificeringen (SOC 2, ISO 27001, HIPAA)
- Kwaliteit van de ontwikkelaarservaring
- Transparantie van het commerciële model
Hoe verhouden documentbeheer en workflowautomatisering zich tot IDP? Documentbeheer, workflowautomatisering en IDP zijn drie functies die samenwerken. Documentbeheersystemen (DMS) zorgen voor de opslag, versiebeheer en toegangscontrole van documenten. Workflowautomatisering bepaalt de volgorde van stappen die een document doorloopt. IDP voegt de AI-laag toe die de inhoud van documenten begrijpt. In de praktijk werken deze drie functies samen: documenten worden opgeslagen en beheerd in een DMS, workflowautomatisering leidt ze door een proces en IDP haalt de gegevens eruit en maakt de inhoud bij elke stap bruikbaar.