Ogni organizzazione si basa sui documenti: contratti, fatture, richieste di risarcimento, cartelle cliniche, permessi, pratiche amministrative. Questi documenti passano da un team all’altro, da un sistema all’altro e da un processo all’altro centinaia o migliaia di volte al giorno e, nella maggior parte delle organizzazioni, ciò avviene ancora prevalentemente grazie al lavoro manuale di qualcuno.
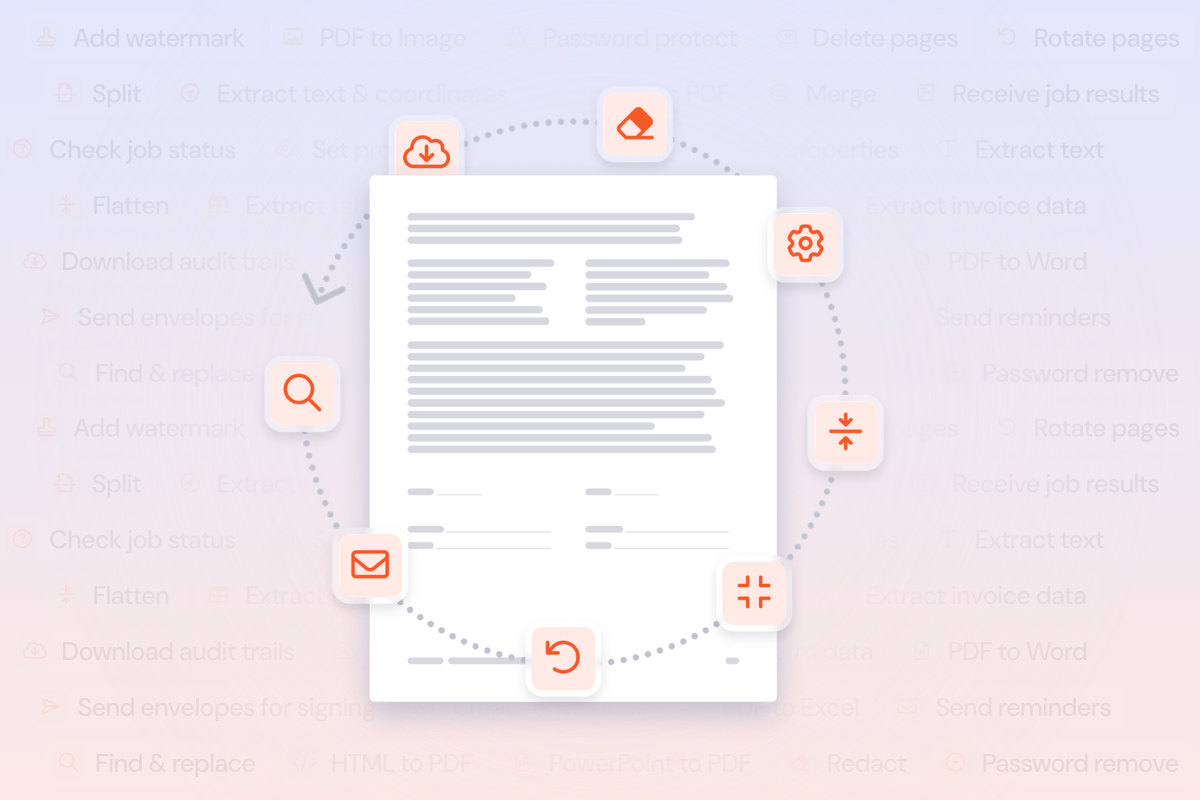
L’automazione dei documenti consiste nell’integrare le operazioni relative ai documenti direttamente nei flussi di lavoro, nei sistemi e negli agenti di intelligenza artificiale già utilizzati dalle organizzazioni, in modo che i documenti vengano elaborati in modo programmatico anziché manualmente. Copre ogni aspetto, dalla conversione dei formati di file e dall’estrazione di dati strutturati alla mascheratura delle informazioni sensibili e all’inoltro dei documenti per la firma elettronica. Basata su un’infrastruttura documentale interna dedicata, garantisce una resa visiva esatta, un’estrazione accurata dei dati e un’esecuzione deterministica su larga scala con una disponibilità superiore al 99,9%. Le operazioni vengono definite una sola volta e poi eseguite automaticamente, innescate da eventi nei sistemi esistenti, indipendentemente dal volume richiesto dall’azienda.
Questa guida illustra cos’è l’automazione dei documenti, in che modo si differenzia dagli strumenti di base per la gestione dei documenti e dall’RPA, i flussi di lavoro che gestisce, come le organizzazioni la implementano (anche tramite agenti di intelligenza artificiale) e come valutare se rappresenta la scelta giusta per il vostro team.
In che modo l’automazione dei documenti si differenzia dagli strumenti di gestione dei documenti
La maggior parte delle organizzazioni dispone già di strumenti per la gestione dei documenti, quali editor di PDF, piattaforme di firma elettronica e sistemi di archiviazione dei file. Questi strumenti sono essenziali per le attività individuali, ma in genere richiedono che qualcuno apra un’applicazione, esegua un’azione e trasferisca manualmente il risultato alla fase successiva.
L’automazione dei documenti apporta due vantaggi chiave ai flussi di lavoro aziendali. Innanzitutto, le operazioni vengono eseguite in modo programmatico. Sono innescate da eventi nei sistemi aziendali, come il caricamento di un file, l’invio di un modulo o il raggiungimento di una fase specifica del flusso di lavoro, e si eseguono autonomamente. In secondo luogo, i flussi di lavoro possono essere potenziati con funzionalità opzionali di intelligenza artificiale, quali l’estrazione automatica dei campi dei moduli, l’analisi delle tabelle, il rilevamento delle informazioni personali identificative (PII) e l’identificazione dei campi di firma, consentendo ai sistemi di interpretare il contenuto dei documenti quando è necessaria un’elaborazione intelligente.
La distinzione è importante perché rappresenta la differenza tra uno strumento che aiuta una persona a svolgere un’attività più rapidamente e un sistema che elimina completamente tale attività dal carico di lavoro della persona.
Comprendere l’elaborazione intelligente dei documenti (IDP)
L’elaborazione intelligente dei documenti (IDP) è un termine spesso utilizzato insieme a quello di automazione intelligente dei documenti. L’IDP si riferisce in genere specificatamente al livello di intelligenza artificiale: la capacità di estrarre, classificare e interpretare i dati dai documenti, compresi i dati non strutturati con cui i sistemi tradizionali basati su regole hanno difficoltà.
I termini “automazione dei documenti basata sull’intelligenza artificiale” e “elaborazione intelligente dei documenti” sono talvolta utilizzati in modo intercambiabile, ma descrivono ambiti diversi. L’IDP si concentra sull’intelligenza: comprendere il contenuto di un documento, identificare i campi rilevanti, classificare i tipi di documento ed estrarre i dati con precisione anche quando il layout varia a seconda delle fonti. L’automazione intelligente dei documenti ha un ambito più ampio. Comprende le funzionalità dell’IDP, ma copre anche l’intero ciclo di vita delle operazioni sui documenti, dalla conversione del formato fino al completamento della firma elettronica, implementata nei flussi di lavoro in cui il lavoro viene effettivamente svolto.
Un termine correlato che occasionalmente causa confusione è «elaborazione intelligente dei dati». Sebbene sembri simile, l’elaborazione intelligente dei dati si riferisce generalmente alla pratica più ampia di applicare l’IA a qualsiasi pipeline di dati, strutturata o non strutturata, tra database, flussi e file. L’IDP si occupa specificamente dei documenti: PDF, immagini scansionate, moduli, contratti e altri contenuti basati su file che contengono le informazioni su cui le organizzazioni devono agire.
Come funziona l’IDP per i moduli e l’estrazione dei dati
La funzionalità principale dell’elaborazione intelligente dei documenti consiste nel trasformare il contenuto dei documenti in dati strutturati e utilizzabili. Per i moduli, ciò significa identificare le etichette dei campi e i valori corrispondenti, anche quando il layout dei moduli varia a seconda dei fornitori, dei reparti o delle regioni. Per le tabelle, significa riconoscere righe, colonne, intestazioni e valori delle celle, per poi estrarli in un formato che possa essere integrato direttamente in un CRM, un ERP, un database o un flusso di lavoro a valle.
L’estrazione basata sull’intelligenza artificiale va oltre il semplice riconoscimento di modelli. Gli approcci tradizionali si basano su modelli o coordinate fisse, che non funzionano più quando il layout di un documento cambia. L’IDP utilizza l’apprendimento automatico e l’elaborazione del linguaggio naturale per comprendere il significato semantico dei contenuti presenti in una pagina, in modo da poter estrarre i dati corretti da una fattura mai vista prima o analizzare un modulo di richiesta di rimborso proveniente da un nuovo fornitore, con lo stesso livello di precisione.
Come IDP gestisce i dati non strutturati
I dati strutturati, come un modulo compilato con campi etichettati, sono relativamente semplici da estrarre. Il problema più complesso è rappresentato dai dati non strutturati: paragrafi di testo libero nei contratti, sezioni descrittive nelle cartelle cliniche, note scritte a mano su documenti scansionati o corrispondenza formattata in modo non uniforme.
L’elaborazione intelligente dei documenti affronta questa sfida attraverso l’elaborazione del linguaggio naturale (NLP) e, sempre più spesso, modelli linguistici di grandi dimensioni in grado di interpretare il contesto, identificare entità ed estrarre significato da testi privi di una struttura predefinita. È proprio questo che consente all’automazione di estrarre termini chiave da una clausola contrattuale, identificare codici di diagnosi in una nota clinica o evidenziare date rilevanti in un atto legale, anche quando non esistono due documenti con lo stesso formato.
Quali flussi di lavoro relativi ai documenti può gestire l’automazione?
L’automazione dei documenti copre le fasi operative che i documenti attraversano durante il loro ciclo di vita all’interno di un’organizzazione. Queste fasi sono spesso invisibili finché non causano un ritardo o un errore, ma rappresentano una quota significativa del carico di lavoro manuale a carico dei team.
Conversione e ottimizzazione dei formati
I documenti arrivano in un formato e devono essere convertiti in un altro. I file Word devono essere convertiti in PDF prima di poter essere archiviati. I fogli di calcolo devono essere convertiti prima di poter essere allegati a una documentazione di conformità. I file immagine devono essere trasformati in PDF ricercabili. Queste conversioni avvengono costantemente, in ogni reparto, e ciascuna di esse rappresenta una fase manuale che l’automazione può eliminare completamente.
Un'API per la generazione di PDF gestisce il tutto a livello di programmazione: il sistema invia il file di origine, specifica il formato di destinazione e riceve il file convertito, il tutto senza alcun intervento manuale da parte dell’utente. La conversione viene eseguita in background come parte di un flusso di lavoro più ampio.
Estrazione dei dati
Una delle applicazioni di maggior valore dell’elaborazione intelligente dei documenti è l’estrazione di dati strutturati da documenti pensati per essere letti da persone. Fatture, contratti, moduli di registrazione, documenti relativi a richieste di risarcimento e rendiconti finanziari contengono tutti dati necessari ai sistemi a valle e, nella maggior parte delle organizzazioni, c’è ancora qualcuno che inserisce manualmente tali dati o li copia da una schermata all’altra.
L’automazione dei documenti estrae campi dei moduli, valori delle tabelle, voci di riga, proprietà dei documenti, informazioni personali identificabili (PII) e metadati in modo programmatico utilizzando l’OCR e trasferisce l’output strutturato direttamente nei sistemi CRM, ERP, nei database o nei flussi di lavoro a valle. L’estrazione basata sull’intelligenza artificiale gestisce le variazioni nel layout dei documenti, consentendo al sistema di elaborare fatture di fornitori diversi o moduli di registrazione provenienti da strutture diverse con lo stesso livello di precisione.
Anonimizzazione e conformità
I settori soggetti a regolamentazione devono rimuovere le informazioni sensibili dai documenti prima che questi possano essere condivisi, archiviati o pubblicati. La redazione manuale richiede molto tempo ed è soggetta a errori, in particolare quando si tratta di grandi insiemi di documenti in cui un singolo elemento tralasciato comporta un rischio di non conformità.
La redazione automatizzata utilizza l’elaborazione del linguaggio naturale per identificare le informazioni di identificazione personale (PII), i dati finanziari, le informazioni sanitarie e altri contenuti sensibili in interi insiemi di documenti, per poi rimuoverli in modo permanente e applicare controlli tramite password per garantire il rispetto delle politiche di accesso e distribuzione. La redazione è coerente, verificabile e viene eseguita indipendentemente dal volume richiesto dal flusso di lavoro.
Trasformazioni dei documenti
Si tratta delle operazioni di routine a cui vengono sottoposti i documenti durante il loro percorso. Unire più file in un unico pacchetto. Suddividere un documento di grandi dimensioni in sezioni. Comprimere i file per l’archiviazione o la trasmissione. Applicare filigrane, protezione tramite password o controlli delle autorizzazioni. Appiattire i moduli prima dell’archiviazione. Ruotare le pagine, riordinare le sezioni o ottimizzare le dimensioni dei file.
Presi singolarmente, ciascuno di questi passaggi richiede pochi minuti. Ma, considerando migliaia di documenti al mese, questi passaggi costituiscono uno dei carichi di lavoro manuale più ingenti per un team. L’automazione del flusso di lavoro dei documenti elimina questi passaggi definendo le operazioni una sola volta ed eseguendole ogni volta che si attiva un trigger.
Flussi di lavoro relativi alle firme elettroniche
Eliminate il lavoro manuale legato alla raccolta delle firme sui vostri documenti. I flussi di lavoro automatizzati per la firma elettronica gestiscono l’intero ciclo: invio automatico di richieste di firma per più documenti e più parti, monitoraggio dello stato delle firme e avvio della fase successiva non appena la firma è completata. Il flusso di lavoro si esegue autonomamente dal momento in cui viene attivato, senza richiedere alcun intervento manuale, sia che si tratti della chiusura di un affare nel vostro CRM, dell’approvazione di una richiesta di risarcimento o di un processo di onboarding che raggiunge la fase della firma.
Dove l’automazione dei documenti offre il massimo valore
L’automazione dei documenti trova applicazione in tutti i settori, ma l’impatto è più immediato nelle operazioni in cui il volume dei documenti è elevato, l’elaborazione è soggetta a scadenze strette e l’accuratezza ha un peso normativo.
- I team dei servizi finanziari gestiscono migliaia di fatture, estratti conto, documenti fiscali e dichiarazioni di conformità. L’automazione gestisce l’estrazione dei dati dalle fatture su larga scala, la conversione da PDF a Excel per i bilanci, la compilazione dei pacchetti di documenti fiscali e la preparazione delle dichiarazioni normative.
- La contabilità fornitori è uno dei punti di ingresso più comuni per l’elaborazione intelligente dei documenti in tutti i settori. I team della contabilità fornitori ricevono fatture in vari formati da centinaia di fornitori e ciascuna deve essere abbinata a un ordine di acquisto, convalidata e inoltrata per l’approvazione. L’IDP estrae automaticamente le voci di fattura, i totali, i dettagli del fornitore e i termini di pagamento e li trasferisce all’ERP, eliminando l’inserimento manuale dei dati che in genere richiede più tempo nel ciclo della contabilità fornitori.
- I team legali devono affrontare colli di bottiglia nella fase di discovery, nella revisione dei contratti e nella preparazione dei documenti da depositare in tribunale. L’automazione estrae i termini contrattuali e i dati relativi alle clausole, elabora i documenti di discovery tramite OCR e oscuramento delle informazioni sensibili, e assembla i fascicoli con la struttura, l’impaginazione e i controlli di sicurezza corretti.
- I teamoperativi del settore assicurativo gestiscono l’elaborazione di un elevato volume di richieste di risarcimento, l’acquisizione di documenti digitalizzati e la generazione di polizze. L’elaborazione intelligente dei documenti nel settore assicurativo automatizza l’acquisizione dei documenti relativi alle richieste di risarcimento (spesso digitalizzati o fotografati), estrae i dati necessari ai periti, classifica i tipi di documento e attiva le richieste di firma non appena i file sono pronti. La stessa automazione si applica ai rinnovi delle polizze, alle richieste di sottoscrizione e agli adempimenti normativi.
- I team del settore sanitario gestiscono i moduli di accettazione dei pazienti, la documentazione relativa alle sperimentazioni cliniche, l’elaborazione delle cartelle cliniche e la documentazione di fatturazione. L’elaborazione intelligente dei documenti nel settore sanitario estrae dati strutturati dai moduli di accettazione, elabora le cartelle cliniche tramite OCR, gestisce i flussi di lavoro della documentazione clinica e supporta l’automazione della fatturazione e della codifica su scala adeguata alle esigenze dei sistemi sanitari. La conformità all’HIPAA e ad altre normative sui dati dei pazienti rende particolarmente importante l’infrastruttura di sicurezza alla base dell’automazione.
- I team di logistica e della catena di approvvigionamento gestiscono polizze di carico, documentazione doganale, ordini di acquisto e contratti con i fornitori, con volumi elevati e tempistiche serrate. L’elaborazione intelligente dei documenti per gli spedizionieri automatizza l’estrazione dei dati di spedizione, delle dichiarazioni doganali e dei dettagli delle fatture commerciali, riducendo l’elaborazione manuale che causa ritardi in porto o durante il trasporto.
- Gli studidi servizi professionali gestiscono lettere di incarico, relazioni per i clienti, documentazione di revisione e gestione delle conoscenze. L’automazione si occupa dell’elaborazione di contratti e lettere di incarico, della generazione di relazioni per i clienti (unione, conversione, filigrana) e della preparazione della documentazione di revisione.
In ogni caso, il valore deriva dall’eliminazione delle fasi manuali tra i sistemi, dalla riduzione del tasso di errore nelle attività ripetitive e dalla possibilità per il team di concentrarsi sul lavoro che richiede capacità di giudizio.
4 modi in cui le organizzazioni implementano l’automazione dei documenti
Esistono diversi modi per implementare l’automazione intelligente dei documenti e la scelta del percorso più adatto dipende dalle competenze tecniche del team, dai sistemi già in uso e dalla complessità dei flussi di lavoro coinvolti.
1. Integrazione diretta tramite APII team di sviluppo integrano le operazioni sui documenti direttamente nelle applicazioni personalizzate, negli strumenti interni e nei sistemi aziendali utilizzando API per PDF e documenti. Questo è il percorso più indicato per servizi interni ad alto volume, estensioni ERP e applicazioni personalizzate in cui le operazioni sui documenti fanno parte del prodotto o del flusso di lavoro stesso.
Un’API per la generazione di PDF, ad esempio, consente a un sistema di inviare un file sorgente e ricevere un output convertito, unito o elaborato come parte di un flusso di lavoro automatizzato più ampio. L’autenticazione, la limitazione della frequenza e la gestione degli errori seguono modelli standard, e la maggior parte dei fornitori offre documentazione con esempi di codice funzionante nei linguaggi più diffusi.
L’integrazione tramite API offre il massimo controllo e la massima flessibilità. È la soluzione più adatta per le organizzazioni che devono elaborare grandi volumi di documenti, gestire logiche condizionali complesse o integrare profondamente le operazioni sui documenti nell’architettura esistente.
2. Piattaforme low-code e no-code
I team operativi, gli analisti aziendali e i responsabili dell’automazione possono integrare operazioni sui documenti nei flussi di lavoro esistenti tramite piattaforme come Microsoft Power Automate e Zapier. I connettori predefiniti consentono ai team di configurare le fasi relative ai documenti (convertire un file, estrarre dati, inviare per la firma) come parte di un flusso automatizzato più ampio, il tutto tramite un’interfaccia visiva.
Questo è spesso il modo più veloce per un’organizzazione di iniziare ad automatizzare il lavoro sui documenti. Richiede risorse tecniche minime e i flussi di lavoro possono essere creati e modificati dalle persone più vicine al processo.
3. Agenti di intelligenza artificiale ed elaborazione documentale automatizzata
Gli agenti di IA si occupano sempre più spesso di attività operative che in precedenza richiedevano il coordinamento umano. L’automazione del flusso di lavoro documentale tramite il Model Context Protocol (MCP) consente agli agenti di accedere alle stesse operazioni sui documenti su cui fanno affidamento gli utenti umani: conversione di file, estrazione di dati, inoltro di documenti per la firma e altro ancora.
L’elaborazione documentale basata su agenti va oltre. Anziché eseguire una singola operazione su un documento quando richiesto, un agente di IA con accesso alle funzionalità di automazione documentale può orchestrare autonomamente flussi di lavoro in più fasi. Un agente potrebbe ricevere un allegato e-mail, classificare il tipo di documento, estrarre i dati rilevanti, inoltrarlo al sistema corretto e attivare una richiesta di firma, il tutto nell’ambito di un’unica attività. L’agente valuta ciò che deve accadere e richiama in sequenza le operazioni documentali appropriate.
È qui che la gestione dei documenti e l’automazione dei flussi di lavoro convergono con l’IA. Le operazioni sui documenti in sé sono le stesse (convertire, estrarre, unire, firmare), ma il livello di coordinamento passa da una persona che segue un processo a un agente che lo esegue. MCP è il protocollo che rende possibile tutto ciò, fornendo agli agenti un accesso affidabile e autenticato alle API dei documenti attraverso la stessa interfaccia che utilizzano per altri strumenti operativi.
4. Generatori di flussi di lavoro “no-code”
Alcune soluzioni di automazione dei documenti offrono strumenti visivi per la creazione di flussi di lavoro che consentono ai team di configurare processi documentali in più fasi tramite un'area di lavoro con funzionalità drag-and-drop. Questi strumenti sono progettati per singoli utenti e piccoli team che dispongono di processi documentali che vale la pena automatizzare, ma non hanno le risorse per creare automazioni tramite codice o piattaforme low-code. Funzionalità come i modelli predefiniti, il monitoraggio delle cartelle, i punti di controllo per la revisione e la generazione di flussi di lavoro assistita dall’intelligenza artificiale consentono di passare dall’idea all’automazione operativa in pochi minuti.
Confronto tra l’automazione intelligente dei documenti e l’RPA
L’automazione robotica dei processi (RPA) e l’automazione intelligente dei documenti vengono spesso discusse insieme e possono funzionare bene in combinazione, ma risolvono problemi diversi.
L’RPA automatizza attività ripetitive e basate su regole imitando le interazioni umane con le interfacce software: cliccare sui pulsanti, copiare dati tra i campi, navigare tra le schermate. È efficace per i processi che seguono una sequenza prevedibile e interagiscono con sistemi privi di API. Tuttavia, l’RPA di per sé ha una capacità limitata di interpretare il contenuto dei documenti. Può spostare un file da una posizione all’altra, ma in genere si affida a uno strumento separato per estrarre i dati da quel file o comprenderne il contenuto.
L’automazione intelligente dei documenti fornisce le funzionalità specifiche per i documenti che mancano all’RPA: estrazione basata sull’intelligenza artificiale, conversione di formato, oscuramento dei dati e l’intera gamma di operazioni relative ai PDF e alle firme elettroniche. Le organizzazioni che già utilizzano strumenti RPA spesso aggiungono l’automazione intelligente dei documenti come livello che gestisce l’elaborazione dei documenti all’interno dei loro flussi di lavoro automatizzati esistenti.
I due approcci sono complementari. L’RPA gestisce la navigazione nel sistema e la sequenza delle attività; l’automazione intelligente dei documenti gestisce il contenuto del documento stesso. Per le organizzazioni che stanno valutando le opzioni a loro disposizione, la domanda chiave è se il collo di bottiglia risieda nelle interazioni con il sistema (dove l’RPA è d’aiuto) o nell’elaborazione dei documenti (dove l’IDP e l’automazione dei documenti sono d’aiuto), oppure in entrambi.
Il mercato dell’elaborazione intelligente dei documenti
Il mercato dell’elaborazione intelligente dei documenti ha registrato una crescita significativa, poiché le organizzazioni operanti in settori regolamentati cercano di automatizzare flussi di lavoro caratterizzati da un elevato volume di documenti. Il panorama comprende diverse categorie di fornitori.
Gli specialisti dell’automazione dei documenti offrono API e connettori appositamente progettati per l’elaborazione dei PDF, la firma elettronica, l’estrazione dei dati e la redazione. Questi fornitori si concentrano sul livello operativo dei documenti e sono progettati per integrarsi nei sistemi esistenti.
I fornitori di RPA con componenti aggiuntivi IDP hanno ampliato le proprie piattaforme per includere funzionalità di elaborazione dei documenti, in genere attraverso partnership o acquisizioni. Le funzionalità IDP sono disponibili come moduli all’interno della più ampia piattaforma RPA.
I servizi IDP su piattaforma cloud sono offerti dai principali fornitori di servizi cloud come parte dei loro portafogli di prodotti di intelligenza artificiale e apprendimento automatico. Questi servizi si concentrano principalmente sull’estrazione e la classificazione e richiedono in genere un lavoro di sviluppo aggiuntivo per realizzare flussi di lavoro completi relativi ai documenti.
Le piattaforme IDP autonome si concentrano specificamente sulla classificazione dei documenti e sull’estrazione dei dati, spesso con modelli specifici per settore. Tendono ad essere solide a livello di intelligenza, ma potrebbero richiedere l’integrazione con strumenti separati per la parte operativa (conversione, unione, oscuramento, firma elettronica).
Nel valutare i fornitori, è importante considerare se la soluzione copra l’intero ciclo di vita delle operazioni documentali necessarie o solo la fase di estrazione. Molte organizzazioni iniziano con l’estrazione dei dati e scoprono rapidamente di aver bisogno anche di funzionalità di conversione del formato, oscuramento, assemblaggio dei documenti e firma elettronica; dover ricorrere a più fornitori aggiunge complessità e costi.
Come valutare una soluzione di automazione dei documenti
La scelta della soluzione giusta dipende dai requisiti specifici della vostra organizzazione, ma vi sono diversi aspetti che vale la pena valutare attentamente.
- Ampiezza delle operazioni: la soluzione copre l’intera gamma di operazioni sui documenti richieste dai vostri flussi di lavoro? Conversioni di formato, estrazione dei dati, oscuramento delle informazioni sensibili, trasformazioni e flussi di lavoro per la firma elettronica dovrebbero essere tutti disponibili tramite un unico fornitore, in modo da poter consolidare gli strumenti anziché mettere insieme più soluzioni puntuali.
- Flessibilità di implementazione: è possibile implementare la soluzione secondo il percorso più adatto al proprio team? L’integrazione tramite API, i connettori low-code, l’accesso tramite agenti basati sull’intelligenza artificiale e i generatori visivi di flussi di lavoro si adattano a team e casi d’uso diversi. Le migliori soluzioni supportano tutte queste opzioni, in modo che un flusso di lavoro creato oggi in Power Automate possa passare in seguito a un’integrazione diretta tramite API man mano che le esigenze evolvono.
- Elaborazione intelligente: la soluzione include funzionalità basate sull’intelligenza artificiale come l’estrazione automatica dei campi dei moduli, l’analisi delle tabelle, il rilevamento delle informazioni personali identificative (PII) e l’identificazione dei campi di firma? Sono proprio queste funzionalità a distinguere l’automazione intelligente dei documenti dalle semplici API di gestione dei file.
- Sicurezza e conformità: per i settori regolamentati, l’infrastruttura alla base della soluzione è importante tanto quanto le funzionalità. Verificate la conformità a SOC 2 Tipo II, ISO 27001 e HIPAA. Verificate se i dati dei clienti vengono trattati esclusivamente per l’operazione richiesta e se i dati vengono utilizzati per addestrare modelli di IA. Assicuratevi che la gestione degli accessi, il monitoraggio dell’utilizzo e i controlli sulle credenziali API siano disponibili tramite un portale di amministrazione centralizzato.
- Esperienza degli sviluppatori: se il vostro team effettuerà l’integrazione tramite API, valutate l’esperienza degli sviluppatori: qualità della documentazione pubblica, coerenza dell’autenticazione, standard di gestione degli errori, esempi di codice e reattività del supporto tecnico. Le operazioni sui documenti di livello aziendale meritano un supporto agli sviluppatori di livello aziendale.
- Modello commerciale: le licenze per postazione spesso risultano meno vantaggiose per l’automazione dei documenti rispetto a un modello di prezzo basato sull’utilizzo. Cercate un modello in cui si paghi per le operazioni sui documenti effettivamente completate, con prezzi trasparenti e costi prevedibili su larga scala.
- Analisi e monitoraggio: cercate soluzioni che forniscano dashboard di utilizzo, monitoraggio della qualità e analisi dei flussi di lavoro, in modo da poter monitorare le prestazioni dell’automazione, identificare tempestivamente i problemi e giustificare l’espansione ad ulteriori flussi di lavoro.
Come iniziare a implementare l’automazione dei documenti nella vostra organizzazione
Il punto di ingresso più efficace è l’attività documentale più ripetitiva e con il volume più elevato che il vostro team gestisce attualmente in modo manuale. Le conversioni di formato, l’estrazione di dati di routine e la gestione delle richieste di firma sono punti di partenza comuni perché sono ben definite, lo sforzo manuale è facile da quantificare e il vantaggio derivante dalla loro automazione è immediato.
Da lì, la maggior parte delle organizzazioni passa a flussi di lavoro più complessi man mano che il team acquisisce familiarità con gli strumenti e individua dove si trovano i colli di bottiglia successivi.
Un approccio pratico in 5 fasi:
- Identificare il flusso di lavoro: scegliere un processo relativo ai documenti che si ripete frequentemente, che comporta diverse fasi manuali e che causa ritardi o errori. L’elaborazione delle fatture, l’archiviazione dei contratti, la gestione dei reclami e la preparazione dei documenti per l’inserimento di nuovi dipendenti sono scelte comuni.
- Mappare le fasi: documentare cosa succede al file in ogni fase: cosa avvia il processo, quali trasformazioni o estrazioni avvengono, dove va a finire l’output e chi si occupa attualmente di ogni fase.
- Scegliere un percorso di implementazione: se il vostro team dispone di sviluppatori, l’integrazione tramite API vi offre il massimo controllo. Se il vostro team utilizza Power Automate o Zapier, iniziate con un connettore low-code. Se desiderate effettuare un test rapido con una configurazione minima, cercate un generatore di flussi di lavoro guidato.
- Misurate i risultati: monitorate il tempo risparmiato, la riduzione degli errori manuali e l’aumento del volume di elaborazione. Questi dati costituiscono la base per estendere l’automazione al flusso di lavoro successivo.
- Espandere: una volta che il primo flusso di lavoro funziona in modo affidabile, applicate lo stesso approccio al processo successivo con il maggiore impatto. Il percorso di implementazione, i modelli di integrazione e le conoscenze operative rimangono invariati.
In che modo Nitro Automate supporta l’automazione intelligente dei documenti
Nitro Automate trasforma i processi manuali relativi ai documenti in flussi di lavoro automatizzati, ovunque si svolga il lavoro. Integra le funzionalità di elaborazione dei documenti di livello aziendale di Nitro direttamente negli agenti di intelligenza artificiale, nei flussi di lavoro automatizzati e nelle applicazioni personalizzate già utilizzate dalle organizzazioni.
Nitro Automate supporta quattro modalità di implementazione:
- API per sviluppatori: integrazione di codice personalizzato tramite linguaggi che supportano HTTP.
- Piattaforme di automazione: connettori predefiniti per Microsoft Power Automate e Zapier.
- Connettore Nitro MCP: connettività nativa per consentire agli agenti di intelligenza artificiale di eseguire operazioni sui documenti durante il flusso di lavoro.
- Nitro PDF Pro (in arrivo): area di lavoro con funzione drag-and-drop direttamente all’interno di Nitro PDF Pro per flussi automatizzati senza codice.
Nitro Automate opera sull’infrastruttura certificata di Nitro, conforme agli standard SOC 2 Tipo II, ISO 27001 e HIPAA. I dati dei clienti vengono trattati in modo sicuro e non vengono mai utilizzati per addestrare modelli di IA generativa.
Nitro Automate è già disponibile. Per saperne di più o richiedere una demo, visita il sito gonitro.com/automate .
Domande frequenti su Nitro Automate
Che cos’è l’elaborazione intelligente dei documenti (IDP)? L’elaborazione intelligente dei documenti (IDP) consiste nell’utilizzo dell’intelligenza artificiale , inclusi l’apprendimento automatico, l’elaborazione del linguaggio naturale e i modelli linguistici di grandi dimensioni, per estrarre, classificare e interpretare i dati da documenti quali fatture, contratti, moduli e documenti digitalizzati. Converte tali contenuti in dati strutturati che i sistemi CRM, ERP e altri sistemi aziendali possono utilizzare. L’OCR tradizionale o l’estrazione basata su modelli legge il testo da posizioni fisse. L’IDP, invece, comprende il significato del contenuto, quindi è in grado di gestire layout variabili e testo non strutturato senza modelli predefiniti. L’IDP è il livello di intelligenza artificiale all’interno dell’automazione intelligente dei documenti, che comprende anche operazioni quali la conversione di formato, la redazione e la firma elettronica. L’IDP è il livello di intelligenza artificiale all’interno dell’automazione intelligente dei documenti, che comprende anche operazioni quali la conversione di formato, la redazione e la firma elettronica .
Qual è la differenza tra l’automazione dei documenti basata sull’intelligenza artificiale e l’elaborazione intelligente dei documenti? La differenza sta nell’ambito di applicazione. L’IDP si riferisce specificatamente all’estrazione e alla classificazione dei dati dei documenti basate sull’intelligenza artificiale. L’automazione dei documenti basata sull’intelligenza artificiale abbraccia l’intero ciclo di vita delle operazioni sui documenti: conversione dei formati, estrazione dei dati, oscuramento, assemblaggio dei documenti, flussi di lavoro per la firma elettronica e altro ancora, il tutto implementato attraverso flussi di lavoro automatizzati. L’IDP è una componente dell’automazione dei documenti basata sull’intelligenza artificiale, ma quest’ultima include anche i livelli operativi e infrastrutturali che gestiscono il percorso dei documenti attraverso un flusso di lavoro dall’inizio alla fine.
Che cos’è l’elaborazione documentale agentica? L’elaborazione documentale agentica consiste nell’uso di agenti basati sull’intelligenza artificiale per orchestrare in modo autonomo i flussi di lavoro documentali. Anziché affidare a un essere umano l’attivazione di ogni fase, un agente valuta autonomamente cosa debba accadere a un documento, avvia le operazioni appropriate (estrazione, conversione, unione, inoltro per la firma) e completa il flusso di lavoro in modo indipendente. L’elaborazione agentica dei documenti è resa possibile da protocolli come il Model Context Protocol (MCP), che forniscono agli agenti di IA un accesso autenticato alle API dei documenti.
In che modo l’elaborazione intelligente dei documenti gestisce i dati non strutturati? L’IDP gestisce i dati non strutturati utilizzando l’elaborazione del linguaggio naturale (NLP) e l’apprendimento automatico per interpretare contenuti in formato testo libero, paragrafi narrativi, note scritte a mano e documenti con formattazione non uniforme. A differenza dei sistemi basati su regole che si affidano a modelli e posizioni fisse dei campi, l’IDP è in grado di estrarre significato da contenuti privi di una struttura predefinita, quali clausole contrattuali, note cliniche o corrispondenza.
Come funziona l’IDP per i moduli e l’estrazione dei dati? L’IDP estrae i dati dai moduli identificando le etichette dei campi e i valori corrispondenti, anche quando i layout differiscono a seconda dei fornitori o delle regioni. Per le tabelle, l’IDP riconosce righe, colonne, intestazioni e valori delle celle. L’estrazione basata sull’intelligenza artificiale utilizza l’apprendimento automatico per comprendere la relazione semantica tra etichette e dati, consentendo all’IDP di elaborare un modulo mai visto prima con lo stesso livello di precisione di uno già conosciuto.
Qual è la differenza tra IDP e RPA? L’automazione robotica dei processi (RPA) automatizza le interazioni ripetitive con le interfacce software, come cliccare, copiare e navigare tra le schermate. L’IDP, al contrario, elabora il contenuto dei documenti: estraendo dati, classificandone i tipi e interpretando il testo non strutturato. L’RPA e l’IDP sono complementari. L’RPA gestisce la sequenza delle attività a livello di sistema, mentre l’IDP gestisce il contenuto dei documenti. Molte organizzazioni utilizzano entrambe le tecnologie insieme: l’RPA orchestra il flusso di lavoro e l’IDP fornisce l’intelligenza documentale.
Quali settori traggono il massimo vantaggio dall’elaborazione intelligente dei documenti? L’IDP offre il valore più immediato nei settori caratterizzati da elevati volumi di documenti, elaborazione con scadenze strette e requisiti normativi. I settori più comuni sono i servizi finanziari, le assicurazioni, il settore legale, la sanità, la logistica e le operazioni di contabilità fornitori in tutti i settori. I casi d’uso tipici includono l’elaborazione delle fatture e la presentazione dei documenti di conformità nei servizi finanziari, la gestione dei sinistri e i documenti assicurativi nel settore assicurativo, la ricerca di prove e la revisione dei contratti nel settore legale, le cartelle cliniche e la documentazione clinica nel settore sanitario, nonché i documenti doganali e le polizze di carico nel settore logistico.
In che modo le aziende elaborano i documenti su larga scala con l’IDP? Le aziende elaborano i documenti su larga scala con l’IDP implementandolo tramite API in grado di gestire migliaia di documenti all’ora, con un’estrazione basata sull’intelligenza artificiale che garantisce l’accuratezza indipendentemente dal layout e dal tipo di documento. La chiave per scalare è l’elaborazione programmatica: i documenti vengono acquisiti, classificati, elaborati e instradati automaticamente, con la revisione umana riservata alle eccezioni piuttosto che a ogni singolo documento. I modelli di tariffazione basati sull’utilizzo garantiscono che i costi scalino in modo prevedibile al variare del volume.
Cosa devo cercare in un fornitore di elaborazione intelligente dei documenti? La considerazione più importante nella valutazione di un fornitore di IDP è se la soluzione copra l’intero ciclo di vita del documento o solo il livello di estrazione. I fornitori che richiedono di mettere insieme più strumenti per un flusso di lavoro completo aggiungono complessità e costi. Altri criteri chiave di valutazione includono:
- Ampiezza delle operazioni sui documenti supportate (estrazione, conversione, oscuramento, firma elettronica)
- Flessibilità di implementazione (API, low-code, accesso tramite agenti IA)
- Capacità di IA per i dati non strutturati, certificazioni di sicurezza (SOC 2, ISO 27001, HIPAA)
- Qualità dell’esperienza per gli sviluppatori
- Trasparenza del modello commerciale
In che modo la gestione dei documenti e l’automazione del flusso di lavoro si relazionano all’IDP? La gestione dei documenti, l’automazione del flusso di lavoro e l’IDP sono tre funzionalità che operano in sinergia. I sistemi di gestione dei documenti (DMS) gestiscono l’archiviazione, il controllo delle versioni e l’accesso ai documenti. L’automazione del flusso di lavoro definisce la sequenza di passaggi che un documento deve seguire. L’IDP aggiunge il livello di IA che comprende il contenuto dei documenti. In pratica, queste tre funzionalità operano in sinergia: i documenti vengono archiviati e gestiti in un DMS, l’automazione del flusso di lavoro li indirizza attraverso un processo e l’IDP estrae i dati e rende il contenuto utilizzabile in ogni fase.